
چیزی که از این درس میبری
- جامعهٔ آماری کل گروهی است که قصد شناخت آن را دارید؛ نمونه بخشی از جامعه است که عملاً اندازهگیری میشود.
- نمونهٔ تصادفی مانند یک قاشق از دیگی کاملاً همزده است: در شهری که ۴۰٪ چای مینوشند، نمونههای تصادفی ۱۰۰ نفره همواره نتایجی نزدیک به ۴۰٪ ثبت کردند.
- سوگیری در نمونهگیری (مانند پرسش از یک گوشهٔ خاص) نتیجهٔ ۷۰٪ به دست داد؛ افزایش حجم نمونه با همان شیوه این سوگیری را برطرف نمیکند.
فهرست این درس۷
۰۱جامعهٔ هدف
جامعهٔ آماری و نمونه
جامعهٔ آماری (Population) تمام افرادی هستند که میخواهید دربارهشان بدانید: همهٔ افراد بزرگسال یک کشور، همهٔ مشتریان یک فروشگاه، یا تمام لامپهایی که یک کارخانه در هفته تولید کرده است. نمونه (Sample) بخشی از آن جامعه است که در عمل اندازهگیری میکنید. بررسی کل جامعه تقریباً هیچگاه ممکن نیست، زیرا هزینه و زمان سرسامآوری میطلبد. بنابراین پرسش بنیادین همواره این است: آیا این نمونه بازتابدهندهٔ واقعی کل جامعه هست؟
یک نهاد نظرسنجی میخواهد دیدگاه ۶۰ میلیون بزرگسال یک کشور را بداند و با ۱٬۰۰۰ نفر تماس میگیرد. آن ۶۰ میلیون نفر جامعهٔ آماریاند، و آن ۱٬۰۰۰ نفر نمونه هستند.
یک قاشق از دیگی همزده
برای سنجش میزان نمکِ سوپ، نیازی نیست تمام قابلمه را سر بکشید؛ تنها یک قاشق از آن حقیقت را برملا میکند. اما این قاعده تنها به یک شرط برقرار است: سوپ باید بهخوبی هم زده شده باشد. اگر از روی دیگی همنزده بچشید، هر چقدر هم قاشق بزرگی بردارید، شاید تنها آبِ سوپ را بچشید و هیچ نمکی حس نکنید. در آمار نیز کارکرد نمونه دقیقاً چنین است: یک نمونهٔ کوچک میتواند وضعیت کل یک جامعهٔ بسیار بزرگ را توصیف کند، به شرط آنکه شیوهٔ انتخاب آن همه را بهطور عادلانه دربرگرفته باشد.
خودت رو امتحان کنسؤال ۱ از ۵
دانشگاهی قصد دارد میزان رضایت ۲۰٬۰۰۰ دانشجوی خود را بسنجد و پرسشنامهای را برای ۵۰۰ نفر از آنان ایمیل میکند. در این پژوهش، جامعهٔ آماری کدام است؟
- همان ۵۰۰ دانشجویی که ایمیل را دریافت کردهاند
- تمام ۲۰٬۰۰۰ دانشجوی شاغل به تحصیل در آن دانشگاه
- همهٔ دانشجویان در سرتاسر کشور
- دانشجویانی که به ایمیل پاسخ میدهند
جواب رو ببین
تمام ۲۰٬۰۰۰ دانشجوی شاغل به تحصیل در آن دانشگاه
کاملاً درست است. جامعهٔ آماری کل گروهی است که پژوهشگر میخواهد دربارهشان بداند: هر ۲۰٬۰۰۰ دانشجوی دانشگاه. آن ۵۰۰ نفر نمونه هستند، و افرادی که پاسخ میدهند گروهی حتی کوچکتر خواهند بود.
قدمبهقدم ببین
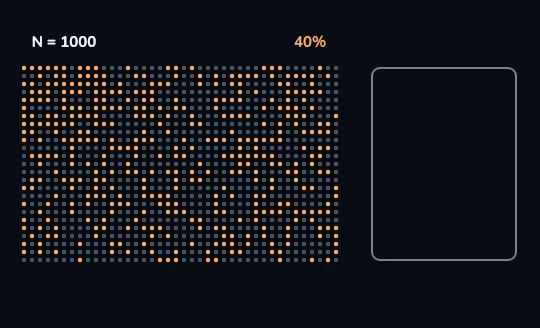
۱/۴شهری با ۱٬۰۰۰ شهروند شهری با ۱٬۰۰۰ نفر جمعیت که هر نقطه نشاندهندهٔ یک شهروند است (۱۰۰۰ = N). نقاط نارنجی (۴۰۰ نفر یا ۴۰ نفر از هر ۱۰۰ نفر) چای را ترجیح میدهند؛ نقاط خاکستری چنین ترجیحی ندارند. کادر خالی در سمت راست در انتظار دریافت یک نمونه است.
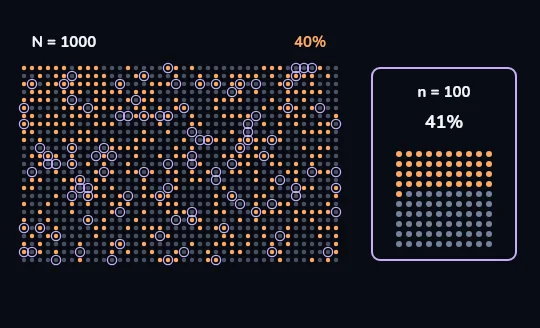
۲/۴نمونهٔ تصادفی ۱۰۰ نفره: نتیجهٔ ۴۱٪ صد نفر که در سراسر شهر پراکندهاند، بهطور تصادفی با دایرههای یاسیرنگ مشخص شده و به کادر نمونه (۱۰۰ = n) منتقل میشوند. پاسخهای آنان چیده شده است: ۴۱٪ از نمونه چای را ترجیح میدهند که بسیار نزدیک به نسبت واقعی (۴۰٪) است.
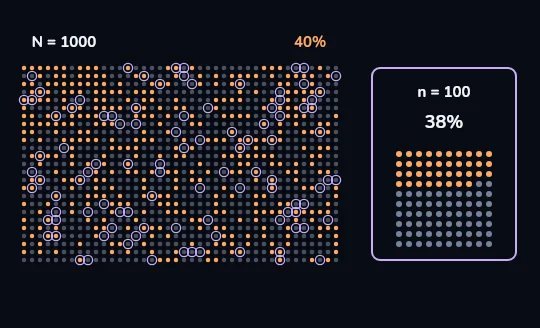
۳/۴نمونههای تصادفی جدید، نتایج جدید حلقهها هر بار روی ۱۰۰ نفر تصادفی جدید جابهجا میشوند و کادر اعدادی مانند ۳۸٪، ۴۳٪، ۴۰٪ و ۴۱٪ را ثبت میکند. هر نمونهٔ تصادفی تفاوتی جزئی دارد، اما همواره در نزدیکی ۴۰٪ نوسان میکند. این نوسان طبیعی را «خطای نمونهگیری» مینامند.
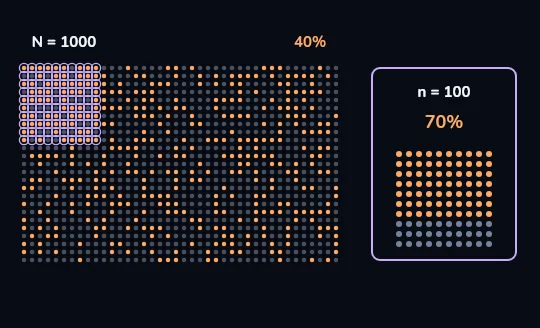
۴/۴پرسش تنها از یک گوشه: نتیجهٔ ۷۰٪ اکنون هر ۱۰۰ نفر تنها از یک گوشه انتخاب میشوند: بلوک بالا-چپ شبکه که اتفاقاً طرفداران چای در آن انباشته شدهاند. کادر عدد ۷۰٪ نارنجی را نشان میدهد، درحالیکه حقیقت جامعه ۴۰٪ است. این یک نمونهٔ سوگیرانه است و پرسش از افراد بیشتر در همان گوشه نیز مشکل را حل نخواهد کرد.
خودت رو امتحان کنسؤال ۲ از ۵
یک نظرسنجی اینترنتی در یک وبسایت خبری ۵۰٬۰۰۰ رأی جمعآوری میکند. همزمان، یک مؤسسهٔ پژوهشی معتبر از ۱٬۰۰۰ بزرگسال بهطور تصادفی نمونهگیری میکند. کدامیک بازتاب بهتری از دیدگاه کل کشور ارائه میدهد؟
- نظرسنجی سایت خبری، زیرا ۵۰٬۰۰۰ نفر حجم بسیار بالاتری است
- نمونهٔ تصادفی ۱٬۰۰۰ نفره، زیرا همهٔ افراد شانسی برابر و عادلانه برای انتخاب شدن داشتهاند
- هر دو به یک اندازه، زیرا هر نظرسنجی با بیش از ۱٬۰۰۰ شرکتکننده معتبر است
جواب رو ببین
نمونهٔ تصادفی ۱٬۰۰۰ نفره، زیرا همهٔ افراد شانسی برابر و عادلانه برای انتخاب شدن داشتهاند
کاملاً درست است. آن ۵۰٬۰۰۰ نفر تنها مخاطبان خاص آن وبسایت هستند که خود تمایل به رأی دادن داشتهاند؛ یعنی گوشهای خاص از کشور مانند گوشهٔ بالا-چپ شبکه. اما ۱٬۰۰۰ نفرِ تصادفی، مانند همان قاشق چشیده شده از یک دیگ کاملاً همزده است.
نمونهگیری تصادفی (Random Sampling)
روشی برای انتخاب نمونه که در آن تکتک اعضای جامعهٔ آماری دارای احتمالی مشخص و ترجیحاً برابر برای انتخاب شدن باشند. این رویکرد معادل آماریِ همان هم زدن دیگ سوپ است. در چنین شرایطی، نمونه تمایل دارد بازتابدهندهٔ کل جامعه باشد، و خطاهای باقیمانده صرفاً نوسانات تصادفی کوچکی موسوم به خطای نمونهگیری (Sampling Error) خواهند بود که اندازهٔ آنها کاملاً قابل محاسبه و پیشبینی است.
نمونههای تصادفی ۱۰۰ نفره از شهر فرضی ما نتایج ۳۸٪، ۴۳٪، ۴۰٪ و ۴۱٪ دادند درحالیکه نسبت واقعی ۴۰٪ بود: هیچگاه عیناً دقیق نیست، اما همیشه نزدیک به حقیقت است.
خودت رو امتحان کنسؤال ۳ از ۵
علت اصلی شکست نظرسنجی مجلهٔ Literary Digest در سال ۱۹۳۶ با وجود دریافت میلیونها پاسخ چه بود؟
- تعداد پاسخدهندگان ناکافی بود
- نمونهگیری سوگیرانه: فهرست افراد و کسانی که داوطلبانه پاسخ دادند نمایندهٔ کل جامعه نبودند
- رأیدهندگان روزولت به مجله اطلاعات نادرست دادند
- مجله در جمعبندی آرای دریافتی دچار خطای محاسباتی شد
جواب رو ببین
نمونهگیری سوگیرانه: فهرست افراد و کسانی که داوطلبانه پاسخ دادند نمایندهٔ کل جامعه نبودند
صحیح است. فهرستهای تماس مجله به سمت اقشار مرفه تمایل داشت و افرادی که انگیزهٔ ارسال پاسخ داشتند نیز ترکیب متفاوتی داشتند. میلیونها پاسخ از یک جامعهٔ سوگیرانه، پاسخی سوگیرانه تولید میکند.
خودگزینی یا خودانتخابی (Self-selection)
وضعیتی که در آن افراد خود تصمیم میگیرند که وارد نمونه شوند یا خیر. نظرسنجیهای اینترنتی، پیامکی و فرمهای «ارزیابی ما» عمدتاً صدای پرانگیزهترین، بسیار خشنودترین یا بهشدت شاکیترین افراد را منعکس میکنند. نتایج حاصل، صرفاً توصیفکنندهٔ افرادِ پاسخدهنده است نه کل جامعه. این پدیده شاخهای از سوگیری نمونهگیری (Sampling Bias) است: هر روشی که شانس انتخاب برخی افراد را نسبت به دیگران ترجیح دهد.
صفحهٔ نظرات یک رستوران آکنده از امتیازهای ۱ ستاره و ۵ ستاره است؛ زیرا خیل پرشمار مشتریانی که غذایی متوسط یا معمولی میل کردهاند، معمولاً زحمت ثبت نظر را به خود نمیدهند.
خودت رو امتحان کنسؤال ۴ از ۵
اگر یک نمونه دارای سوگیری باشد، دو برابر کردن حجم نمونه این سوگیری را برطرف میکند.
- درست
- نادرست
جواب رو ببین
نادرست
نادرست است. افزایش تعداد افراد با همان شیوهٔ معیوب، صرفاً انحراف و خطای اولیه را با قطعیتی بالاتر تکرار میکند. پرسیدن از ۲۰۰ نفر در همان گوشهٔ چایدوست شبکه، باز هم نتیجهای حدود ۷۰٪ خواهد داد، نه ۴۰٪. تنها تغییر شیوهٔ انتخاب نمونه است که سوگیری را برطرف میسازد.
دو سوگیری دیگر که باید بشناسید
عدم پاسخ (Non-response)
افرادی که پاسخ نمیدهند از لحاظ ویژگیها با کسانی که پاسخ میدهند متفاوتاند. اگر والدین پرمشغله و شاغلان شیفت شب هرگز تلفن را پاسخ ندهند، یک نظرسنجی دربارهٔ اوقات فراغت عمدتاً دیدگاه کسانی را منعکس میکند که بیشترین وقت آزاد را دارند.
سوگیری بقا (Survivorship)
زمانی که تنها بازماندگان را بررسی میکنید. این باور که «ساختمانهای قدیمی محکمتر ساخته میشدند»، همهٔ بناهای تاریخی تخریبشده و فروریخته را نادیده میگیرد؛ تنها محکمترین آنها تا امروز سرپا ماندهاند تا مورد تمجید قرار گیرند.
خودت رو امتحان کنسؤال ۵ از ۵
یک باشگاه ورزشی از اعضای خود نظرسنجی میکند، متوجه میشود ۹۰٪ آنان هر هفته ورزش میکنند و سپس تیتر میزند: «۹۰٪ شهروندان این شهر هر هفته ورزش میکنند». اشکال این ادعا چیست؟
- اشکالی ندارد، ۹۰٪ آماری واضح و روشن است
- نمونهٔ پژوهش اعضای باشگاه ورزشی هستند، نه کل جمعیت شهروندی که ادعا متوجه آنان است
- باشگاه میبایست از اعضای کمتری نظرسنجی به عمل میآورد
- میزان ورزش هفتگی را نمیتوان با نظرسنجی سنجید
جواب رو ببین
نمونهٔ پژوهش اعضای باشگاه ورزشی هستند، نه کل جمعیت شهروندی که ادعا متوجه آنان است
کاملاً درست است. اعضای باشگاه دقیقاً کسانی هستند که بالاترین تمایل به ورزش را دارند. این نتیجه شاید دربارهٔ اعضای آن مجموعه صادق باشد، اما جامعهٔ آماریِ مورد ادعا (کل شهروندان شهر) هرگز نمونهگیری نشده است.
۰۶قدمبهقدم
چهار پرسش اساسی پیش از پذیرش هر نظرسنجی
- از چه کسانی پرسش شده است؟
آیا گروه بررسیشده با جامعهٔ آماری مطرحشده در تیتر همخوانی دارد، یا تنها بخش خاصی از آن است؟
- شیوهٔ انتخاب افراد چگونه بوده است؟
آیا انتخاب بهصورت تصادفی بوده، یا افراد خود داوطلب شدهاند، روی لینکی کلیک کردهاند، یا صرفاً در دسترس بودهاند؟
- چه نسبتی از افراد پاسخ دادهاند؟
نرخ پاسخدهی پایین نشان میدهد که نتایج احتمالاً دیدگاه گروهی نامعمول و باانگیزه از میان افراد مورد پرسش است.
- چه کسانی از قلم افتادهاند؟
افراد بدون دسترسی به اینترنت، کسانی که مشغله داشتهاند، یا گروههایی که بقا نیافتهاند. آیا آنان پاسخهای متفاوتی میدادند؟
۰۷جمعبندی
مرور درس
- جامعهٔ آماری کل گروهی است که قصد شناخت آن را دارید؛ نمونه بخشی از جامعه است که عملاً اندازهگیری میشود.
- نمونهٔ تصادفی مانند یک قاشق از دیگی کاملاً همزده است: در شهری که ۴۰٪ چای مینوشند، نمونههای تصادفی ۱۰۰ نفره همواره نتایجی نزدیک به ۴۰٪ ثبت کردند.
- سوگیری در نمونهگیری (مانند پرسش از یک گوشهٔ خاص) نتیجهٔ ۷۰٪ به دست داد؛ افزایش حجم نمونه با همان شیوه این سوگیری را برطرف نمیکند.
- نظرسنجی نشریهٔ Literary Digest در ۱۹۳۶ با وجود ۲٫۴ میلیون پاسخ شکست خورد؛ بزرگی نمونه حریف سوگیری نظاممند نمیشود.
- همواره مراقب سوگیریهای خودگزینی، عدم پاسخ و بقا باشید و چهار پرسش را بررسی کنید: از چه کسانی، چگونه، با چه نرخ پاسخی، و با غیبت چه کسانی نظرسنجی انجام شد.
به سبک خودت یادش بگیر.
توی اپ از یادآی بخواه این درس رو سادهتر توضیح بده، از زندگی خودت مثال بزنه یا عمیقتر بره. بعد یه مسیر کامل دور هدف خودت بساز.