
چیزی که از این درس میبری
- حاشیهٔ خطا بیانگر میزان انحراف احتمالی نظرسنجی بر اثر انتخاب تصادفی افراد است: ۵۲٪ با خطای ۳± یعنی مقدار واقعی احتمالاً بین ۴۹٪ تا ۵۵٪ است.
- در سطح اطمینان ۹۵٪، از هر ۱۰۰ بازهٔ حاصل از نمونهگیری، حدود ۹۵ بازه مقدار واقعی را پوشش میدهند.
- اگر دو نامزد ۵۲٪ و ۴۸٪ با خطای ۳± داشته باشند، بازهها همپوشانی دارند و برنده نامشخص است. در ۴۰۰۰ = n حاشیه به حدود ۱٫۶± کاهش یافته و همپوشانی از میان میرود.
فهرست این درس۴
حاشیهٔ خطا (Margin of Error - MoE)
میزان فاصلهای که نتیجهٔ یک نظرسنجی ممکن است با مقدار واقعی جامعه داشته باشد، صرفاً به این دلیل که چه کسانی بهطور تصادفی در نمونه قرار گرفتهاند. حاصل جمع و تفریق این حاشیه با درصد بهدستآمده، محدودهای را میسازد که بازهٔ اطمینان (Confidence Interval) نامیده میشود: بازهای که مقدار واقعی جامعه به احتمال بسیار بالا در آن قرار دارد.
عبارت «۵۲٪ با خطای ۳±» یعنی مقدار واقعی به احتمال قوی جایی بین ۴۹٪ تا ۵۵٪ است.
خودت رو امتحان کنسؤال ۱ از ۶
یک نظرسنجی نشان میدهد که ۴۰٪ از شهروندان موافق احداث پارکی جدید هستند، با حاشیهٔ خطای ۴± واحد درصد. میزان واقعی حمایت شهروندان احتمالاً در چه محدودهای قرار دارد؟
- دقیقاً ۴۰٪
- بین ۳۶٪ تا ۴۴٪
- بین ۳۸٪ تا ۴۲٪
- در هر نقطهای از ۰٪ تا ۱۰۰٪
جواب رو ببین
بین ۳۶٪ تا ۴۴٪
کاملاً درست است. ۴۰ منهای ۴ برابر ۳۶، و ۴۰ بهعلاوهٔ ۴ برابر ۴۴ است. این محدوده همان بازهٔ اطمینان است.
قدمبهقدم ببین
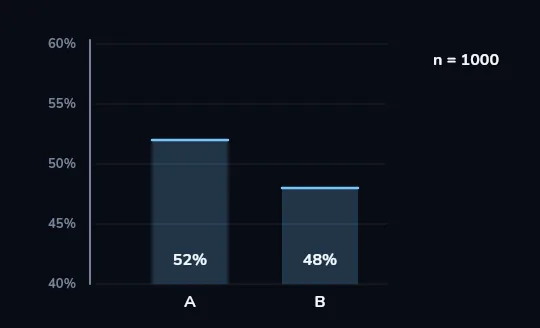
۱/۴نظرسنجی از ۱٬۰۰۰ نفر: ۵۲٪ در برابر ۴۸٪ دو ستون روی محوری از ۴۰٪ تا ۶۰٪: نامزد «الف» با ۵۲٪ و نامزد «ب» با ۴۸٪، برگرفته از نظرسنجی ۱٬۰۰۰ نفره (۱۰۰۰ = n). در نگاه سطحی به ستونها، به نظر میرسد نامزد الف پیشتاز است.
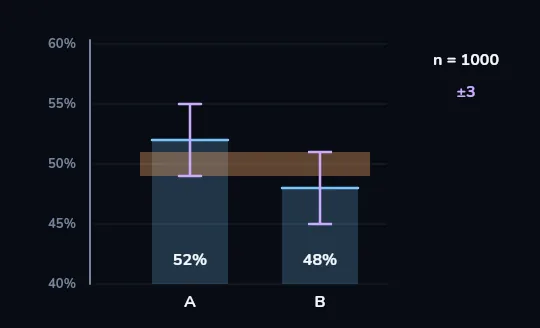
۲/۴اعمال حاشیهٔ ۳±: بازهها همپوشانی دارند خطوط بنفش حاشیهٔ خطای ۳± واحد درصد را نشان میدهند: رأی واقعی الف میتواند در هر نقطهای از ۴۹٪ تا ۵۵٪ باشد، و رأی ب بین ۴۵٪ تا ۵۱٪. نوار نارنجی از ۴۹٪ تا ۵۱٪ نشاندهندهٔ همپوشانی بازههاست؛ بنابراین این نظرسنجی نمیتواند تعیین کند چه کسی واقعاً پیشتاز است.
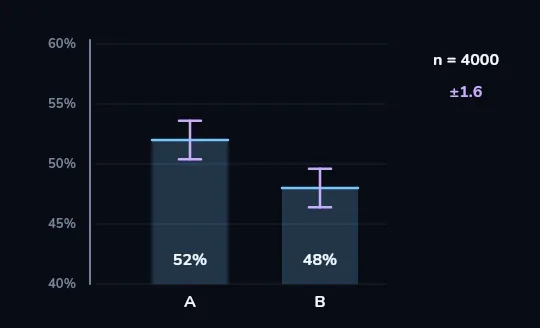
۳/۴پرسش از ۴٬۰۰۰ نفر: حاشیه به ۱٫۶± کاهش مییابد حجم نمونه به ۴٬۰۰۰ نفر افزایش مییابد و بازهٔ خطا به حدود ۱٫۶± واحد درصد کاهش مییابد: الف بین ۵۰٫۴٪ تا ۵۳٫۶٪، و ب بین ۴۶٫۴٪ تا ۴۹٫۶٪. نوار همپوشانی ناپدید شده است؛ اکنون فاصلهٔ دو نامزد بزرگتر از نوسان تصادفی است.
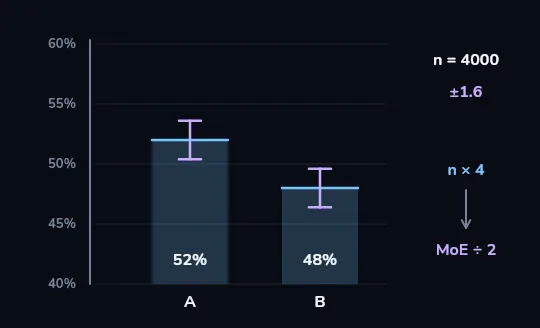
۴/۴چهار برابر شرکتکننده، نصف شدن حاشیهٔ خطا نکتهای در سمت راست پیام اصلی را خلاصه میکند: ۴ برابر شدن حجم نمونه، حاشیهٔ خطا را تنها به نصف کاهش میدهد. به همین دلیل است که اکثر نظرسنجیهای ملی در حدود ۱٬۰۰۰ تا ۲٬۰۰۰ نفر متوقف میشوند.
خودت رو امتحان کنسؤال ۲ از ۶
در یک نظرسنجی ۱٬۰۰۰ نفره، نامزد الف ۵۲٪ و نامزد ب ۴۸٪ رأی آوردهاند (با حاشیهٔ خطای ۳±). آیا روزنامهها مجازند تیتر بزنند که نامزد الف پیشتاز است؟
- بله، زیرا ۵۲ آشکارا از ۴۸ بزرگتر است
- خیر، زیرا بازههای اطمینان همپوشانی دارند و نمیتوان برنده را قطعی دانست
- بله، اما پیشتازی او دقیقاً ۴ واحد درصد است
- خیر، زیرا نظرسنجی حتماً باید از تمام شهروندان پرسیده میشد
جواب رو ببین
خیر، زیرا بازههای اطمینان همپوشانی دارند و نمیتوان برنده را قطعی دانست
کاملاً درست است. بازهٔ نامزد الف (۴۹ تا ۵۵) و بازهٔ نامزد ب (۴۵ تا ۵۱) با یکدیگر همپوشانی دارند؛ بنابراین در واقعیت ممکن است هر یک از آن دو جلوتر باشد. روزنامهنگاران حرفهای به این وضعیت «برابری آماری (Statistical Tie)» میگویند.
۰۲مفهوم دقیق احتمال
سطح اطمینان ۹۵ درصدی
حاشیهٔ خطا معمولاً بر پایهٔ سطح اطمینان ۹۵ درصدی (95% Confidence) محاسبه میشود. تصور کنید همین نظرسنجی با روشی یکسان ۱۰۰ بار تکرار شود و در هر بار یک نمونهٔ تصادفی کاملاً مستقل انتخاب گردد. هر تکرار نتیجه و بازهٔ اطمینان خاص خود را تولید میکند. از میان آن ۱۰۰ بازه، حدود ۹۵ بازه مقدار واقعی جامعه را در بر میگیرند و حدود ۵ بازه ممکن است از آن خطا کنند. بنابراین، یک بازهٔ اطمینان منفرد با احتمال بسیار بالا (نه با قطعیت مطلق) حقیقت جامعه را پوشش میدهد.
اگر در یک فصل انتخاباتی ۲۰ نظرسنجی بیطرفانه و دقیق منتشر شود، کاملاً طبیعی است که حدود یکی از آنها صرفاً بر اثر شانس آماری، خطایی فراتر از حاشیهٔ اعلامشدهاش داشته باشد.
مثال
قاعدهٔ سرانگشتی برای نمونهگیری تصادفی ساده
(سطح اطمینان ۹۵٪، نتایج نزدیک به ۵۰٪):
حاشیهٔ خطا ≈ ۱ / √n
n = ۱۰۰ → ۱ / ۱۰ = ۰٫۱۰
n = ۴۰۰ → ۱ / ۲۰ = ۰٫۰۵
n = ۱۰۰۰ → ۱ / ۳۱٫۶ ≈ ۰٫۰۳۲
n = ۴۰۰۰ → ۱ / ۶۳٫۲ ≈ ۰٫۰۱۶n = ۱۰۰ → حدود ۱۰± واحد درصد
n = ۴۰۰ → حدود ۵± واحد درصد
n = ۱۰۰۰ → حدود ۳± واحد درصد
n = ۴۰۰۰ → حدود ۱٫۶± واحد درصدچهار برابر کردن حجم نمونه (از ۱٬۰۰۰ به ۴٬۰۰۰ نفر) هزینه را چهار برابر میکند اما حاشیهٔ خطا را تنها به نصف میرساند. این موازنهٔ هزینه و دقت دلیل اصلی این است که اکثر نظرسنجیهای ملی در حدود ۱٬۰۰۰ تا ۲٬۰۰۰ نفر انجام میشوند.
خودت رو امتحان کنسؤال ۳ از ۶
یک نظرسنج با نمونهٔ معمول ۱٬۰۰۰ نفره به حاشیهٔ خطای ۳± درصد میرسد. او میخواهد این حاشیه را به ۱٫۵± درصد کاهش دهد. به چه تعداد شرکتکننده نیاز خواهد داشت؟
- حدود ۱٬۵۰۰ نفر
- حدود ۲٬۰۰۰ نفر
- حدود ۴٬۰۰۰ نفر
- حدود ۱۰٬۰۰۰ نفر
جواب رو ببین
حدود ۴٬۰۰۰ نفر
صحیح است. برای به نصف رساندن حاشیهٔ خطا، حجم نمونه باید چهار برابر شود: ۱٬۰۰۰ نفر باید به حدود ۴٬۰۰۰ نفر افزایش یابد.
خودت رو امتحان کنسؤال ۴ از ۶
یک نظرسنجی با ۱٬۰۰۰ شرکتکننده برای کشوری کوچک مناسب است، اما برای کشوری پهناور و پرجمعیت به نمونهای حدود ۱۰۰٬۰۰۰ نفر نیاز داریم.
- درست
- نادرست
جواب رو ببین
نادرست
نادرست است. وقتی اندازهٔ جامعه از حد معینی فراتر رود، بزرگی آن عملاً تأثیری در حاشیهٔ خطا ندارد. یک نمونهٔ تصادفی ۱٬۰۰۰ نفره، چه در کشوری ۵ میلیونی و چه در کشوری ۳۰۰ میلیونی، حاشیهٔ خطایی در حدود ۳± واحد درصد تولید میکند.
نکات کلیدی در خواندن نتایج نظرسنجیها
- حاشیهٔ خطای حاکم بر اختلاف دو نامزد، تقریباً دو برابر حاشیهٔ خطای هر یک است. با حاشیهٔ ۳±، پیشتازی ۴ واحدی در محدودهٔ نوسان تصادفی است.
- زیرگروهها حاشیهٔ خطای بسیار بزرگتری دارند. اگر از ۱٬۰۰۰ نفر تنها ۱۰۰ نفر جوانان ۱۸ تا ۲۴ ساله باشند، حاشیهٔ خطای آن گروه حدود ۱۰± درصد خواهد بود.
- تغییرات ۱ یا ۲ واحد درصدی بین دو نظرسنجیِ متوالی معمولاً بیانگر چرخش واقعی آرا نیست.
- بزرگتر بودن کشور لزوماً نیازمند نمونهٔ بهمراتب بزرگتر نیست.
خودت رو امتحان کنسؤال ۵ از ۶
حاشیهٔ خطا در برابر کدامیک از عوامل زیر هیچ اطمینان یا محافظتی ایجاد نمیکند؟
- شانس تصادفیِ اینکه چه افرادی در نمونه قرار گرفتهاند
- نمونهای که منحصراً از دارندگان تلفن ثابت انتخاب شده است
جواب رو ببین
نمونهای که منحصراً از دارندگان تلفن ثابت انتخاب شده است
کاملاً درست است. شانس تصادفی همان چیزی است که حاشیهٔ خطا اندازهگیری میکند. اما نمونهگیریِ صرفاً بر پایهٔ تلفن ثابت دارای سوگیری ساختاری است: اقشار متعددی را کلاً نادیده میگیرد و هیچ حاشیهٔ خطایی نمیتواند این عیب بنیادین را خنثی کند.
خودت رو امتحان کنسؤال ۶ از ۶
- هفتهٔ نخست: نظرسنجی تصادفی از ۱٬۰۰۰ نفر، میزان رأی حزب الف را ۴۴٪ با حاشیهٔ خطای ۳± درصد تخمین میزند.
- هفتهٔ دوم: نظرسنجی تصادفی جدیدی از ۱٬۰۰۰ نفر با روشی مشابه، رأی حزب الف را ۴۶٪ نشان میدهد. یک روزنامه تیتر میزند: «جهش محبوبیت حزب الف».
منصفانهترین و علمیترین تحلیل از این دو نظرسنجی چیست؟
- حزب الف بهوضوح ۲ واحد درصد محبوبیت بیشتری پیدا کرده است
- تغییر ۲ واحدی کاملاً در محدودهٔ نوسان تصادفی است؛ شاید محبوبیت اصلاً تغییری نکرده باشد
- نظرسنجی دوم بدون تردید سوگیرانه بوده است
- حزب الف در واقعیت با افت محبوبیت مواجه شده است
جواب رو ببین
تغییر ۲ واحدی کاملاً در محدودهٔ نوسان تصادفی است؛ شاید محبوبیت اصلاً تغییری نکرده باشد
دقیقاً درست است. در هر نظرسنجی احتمال خطای تصادفی حدود ۳ واحد درصد وجود دارد؛ بنابراین مشاهدهٔ اختلافی ۲ واحدی میان دو نوبت، حتی اگر هیچ تغییری در نگرش جامعه رخ نداده باشد، کاملاً قابل انتظار است. اطلاق «جهش» به این تغییر، تبدیل نویز آماری به تیتر خبری است.
۰۴جمعبندی
مرور درس
- حاشیهٔ خطا بیانگر میزان انحراف احتمالی نظرسنجی بر اثر انتخاب تصادفی افراد است: ۵۲٪ با خطای ۳± یعنی مقدار واقعی احتمالاً بین ۴۹٪ تا ۵۵٪ است.
- در سطح اطمینان ۹۵٪، از هر ۱۰۰ بازهٔ حاصل از نمونهگیری، حدود ۹۵ بازه مقدار واقعی را پوشش میدهند.
- اگر دو نامزد ۵۲٪ و ۴۸٪ با خطای ۳± داشته باشند، بازهها همپوشانی دارند و برنده نامشخص است. در ۴۰۰۰ = n حاشیه به حدود ۱٫۶± کاهش یافته و همپوشانی از میان میرود.
- چهار برابر کردن نمونه حاشیه را نصف میکند، و بزرگی جمعیت جامعهٔ آماری نقشی در این میان ندارد.
- زیرگروهها حاشیهٔ خطای بهمراتب بزرگتری دارند، و حاشیهٔ خطا هرگز سوگیری نمونه یا پرسشهای گمراهکننده را پوشش نمیدهد.
به سبک خودت یادش بگیر.
توی اپ از یادآی بخواه این درس رو سادهتر توضیح بده، از زندگی خودت مثال بزنه یا عمیقتر بره. بعد یه مسیر کامل دور هدف خودت بساز.